v0.2.5 Motor OASIS · CAMEL-AI · arXiv:2411.11581 ↗

Simulación Social con Agentes de Lenguaje y Rigor Empírico

Diseña poblaciones sintéticas y orquesta interacciones con rigor empírico.

Metodología evaluada en escenarios reproducibles · Exportación abierta a Gephi, SQLite y GEXF
Ejemplo ilustrativo (datos ficticios) · Ciclovía y Movilidad Centro Ronda 4 / 8
Twitter Sandbox 24 Agentes
Métricas de Dinámica Fórmula
Bimodalidad de Sarle (b)
0.618 Bimodal (>0.555)
Polarización consolidada
Índice Cámara de Eco
78.4% Alta
Seguimientos intra-grupo
Afinidad de Valoración
84.2% Esperada
Likes afines a postura previa
Cascadas de Retuit
3 activas Prof. máx: 4
Feed de la Red Sandbox Algoritmo: Hot Score
SV
@sofia_val · Ciclista Urbana (Postura: 4.8/5)
Ronda 4 · T+12s
El informe del observatorio indica que un carril protegido reduce siniestros viales un 38%. Exigimos que la Secretaría mantenga la obra y no ceda ante presiones corporativas.
RC
@roberto_comercio · Comerciante Central (Postura: 1.4/5)
Ronda 4 · T+28s
Nos cancelaron 40 cajones de carga y descarga sin aviso. Las ventas ya cayeron 22% esta semana. Si cierran el acceso vehicular, convocaremos al paro de locales.
DM
@dr_mendoza · Observador Técnico (Postura: 3.0/5)
Ronda 4 · T+45s
Dato empírico verificable: los corredores ciclistas con estacionamiento regulado aumentan el flujo peatonal en 11%. Hay margen para una mesa de rediseño logístico.
Grafo de Comunidades Label Prop. Dinámico
Cluster A (Pro) Cluster B (Anti)
Pro-movilidad (11 agentes)
Comercio local (10 agentes)
Moderadores técnicos (3 agentes)
Semilla: 0x7F2A · Simulación activa en tiempo real
Topología del Sistema · CAMEL-AI

Arquitectura de Simulación Multicapa

Flujo computacional desacoplado: desde la generación del perfil psicológico hasta la medición analítica de polarización.

CAPA 01

Agentes Sintéticos

Perfiles Big Five, demografía, creencias previas y memoria reflexiva persistente.

CAPA 02

Entorno de Red

Simulación X/Reddit con algoritmos de recomendación, cronología y retroalimentación.

CAPA 03

Motor Analítico

Coeficiente de Sarle ($b > 0.555$), análisis de cámaras de eco y clustering semántico.

10,000+
Agentes Concurrentes
Simulación a gran escala validada bajo arquitectura CAMEL-AI.
128K
Ventana de Contexto
Modelado profundo de memoria e interacciones longitudinales.
0.89
F1-Score Empírico
Alineación predictiva con dinámicas de opinión pública reales.
128K
Ventana de Contexto
Modelado profundo de memoria e interacciones longitudinales.
0.89
F1-Score Empírico
Alineación predictiva con dinámicas de opinión pública reales.
Arquitectura construida sobre estándares abiertos y reproducibilidad computacional:
CAMEL-AI Core
Watts-Strogatz Network
Gephi (GEXF v1.2)
NetworkX Engine
Sarle Bimodality Metric
Persistencia SQLite
Ollama Local Compatible

Prueba tu pregunta de investigación o sube la narrativa del hecho

Ingresa directamente la interrogante que necesitas evaluar, describe los antecedentes o adjunta la documentación oficial (PDF, Word, notas de prensa). El motor extraerá la ontología social de actores, tensiones y posturas para modelar el escenario.

oasis://laboratorio/diseno_asistido_v3.json
Inferencia Asistida Activa
Casos de prueba sugeridos: Reforma vial y ciclovía Campaña de vacunación y rumor Consulta de horario escolar
[DOC]
Adjuntar documento o informe técnico Formatos admitidos: PDF, DOCX, TXT (hasta 60k caracteres)
[NET]
Configuración de relaciones y poder Se generan 12 a 25 agentes con asignación de roles y pesos
Esta acción estructura la ontología previa y los agentes sin correr a ciegas.
Ontología Social Extraída (Lista para Revisión) Tensión central detectada: Fricción logística

A partir de la pregunta ingresada, el modelo formuló la hipótesis de trabajo y detectó los siguientes actores clave con sus posturas iniciales:

Colectivo Ciclista Urbano (Postura: +0.80 · Poder: 3/5)
Comerciantes de Carga (Postura: -0.75 · Poder: 4/5)
Asociación de Automovilistas (Postura: -0.60 · Poder: 3/5)
Vecinos Residentes (Postura: +0.10 · Poder: 2/5)
Dirección de Movilidad (Postura: +0.90 · Poder: 5/5)
¿Deseas ejecutar la simulación y medir el Coeficiente de Sarle con este escenario? Cargar en OASIS Studio →
Experiencia de Producto & Rigor Metodológico

La Plataforma en Acción: In Silico Testbed

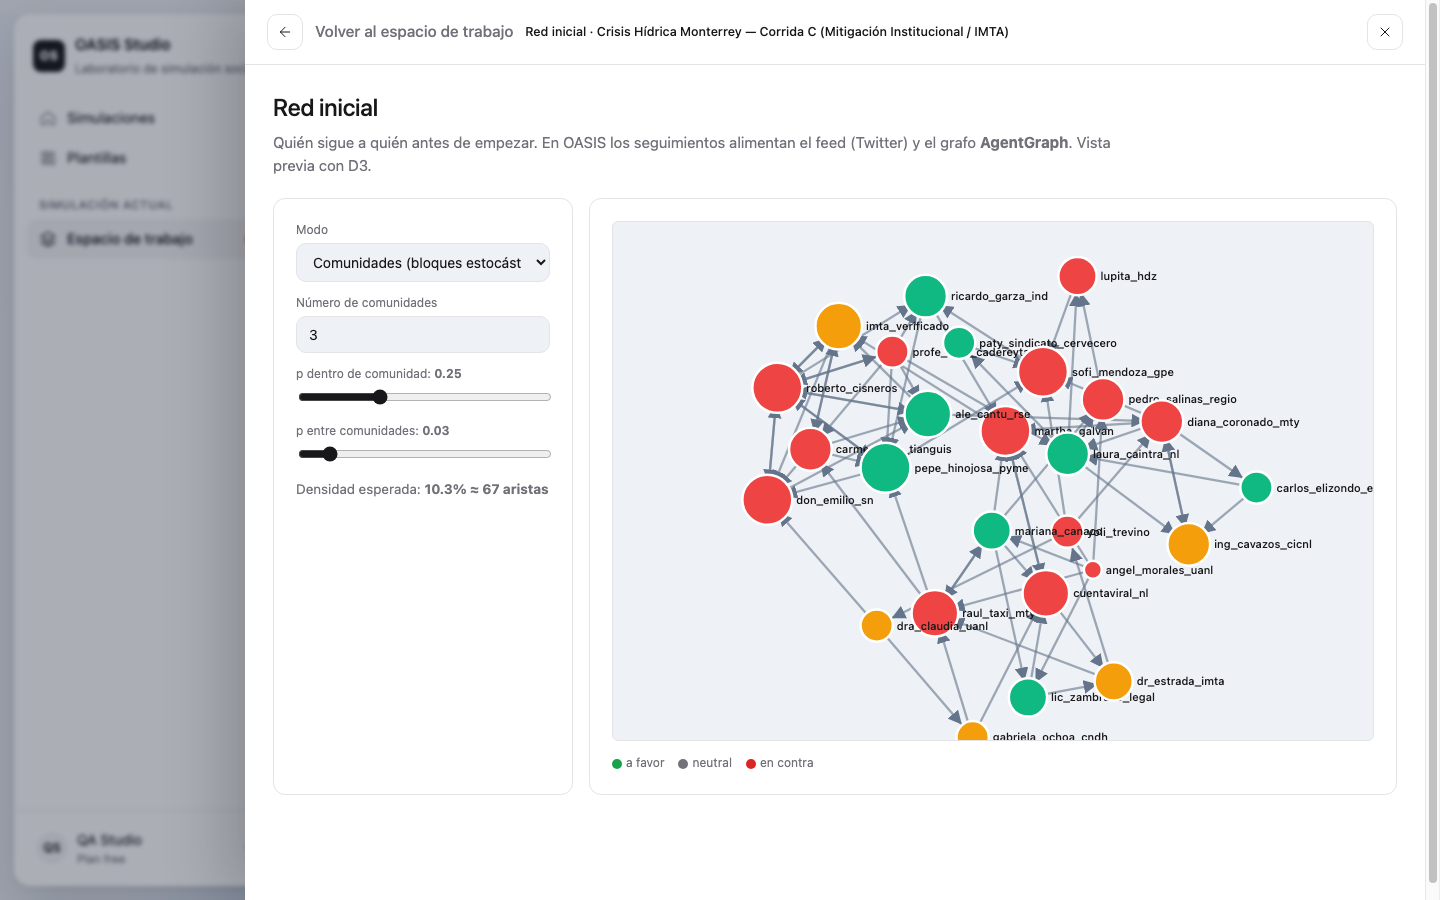
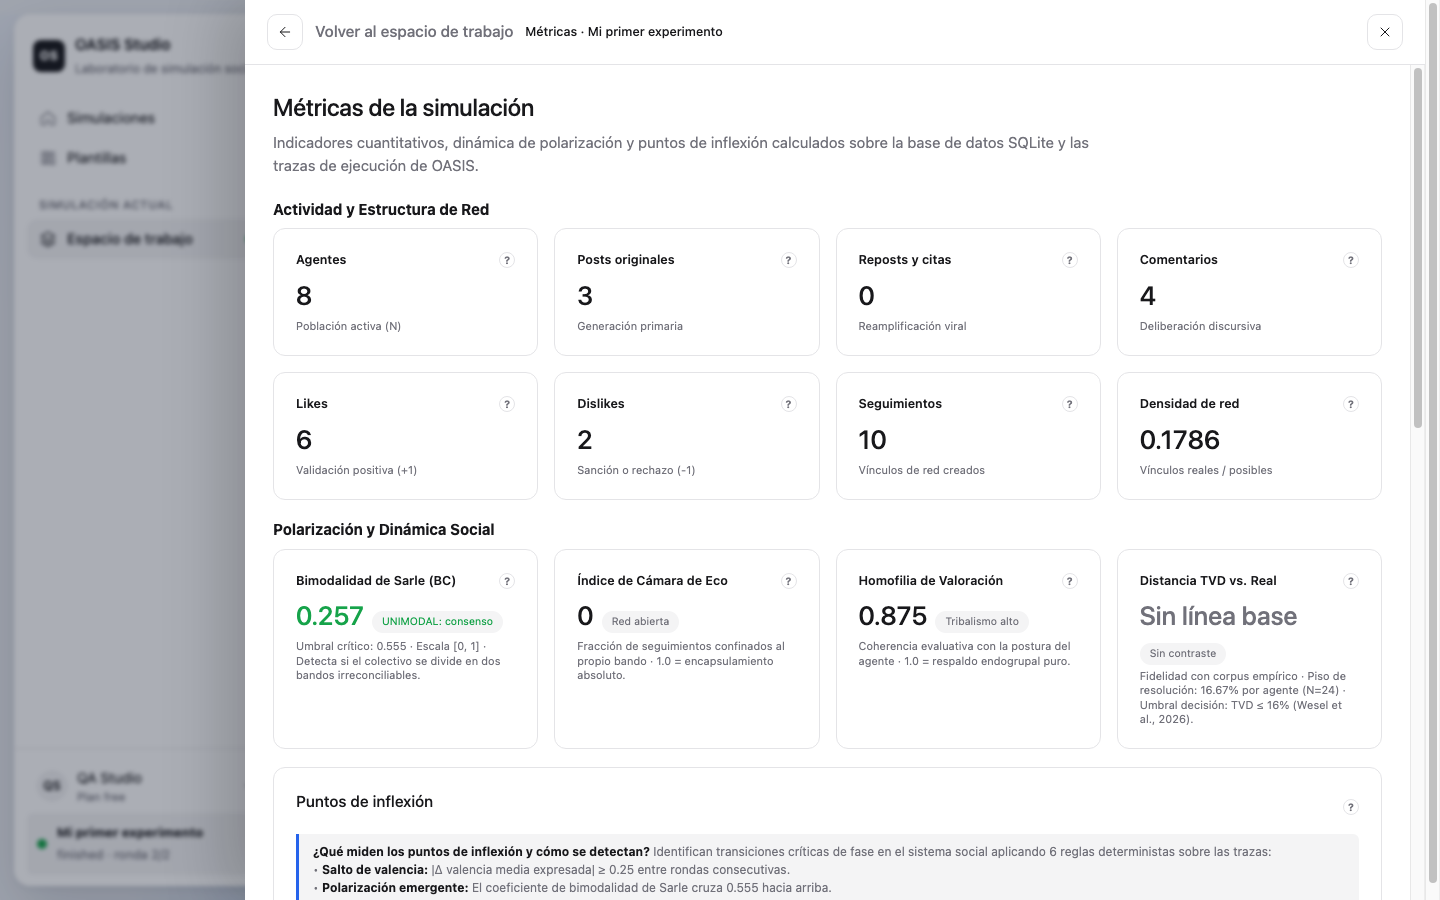
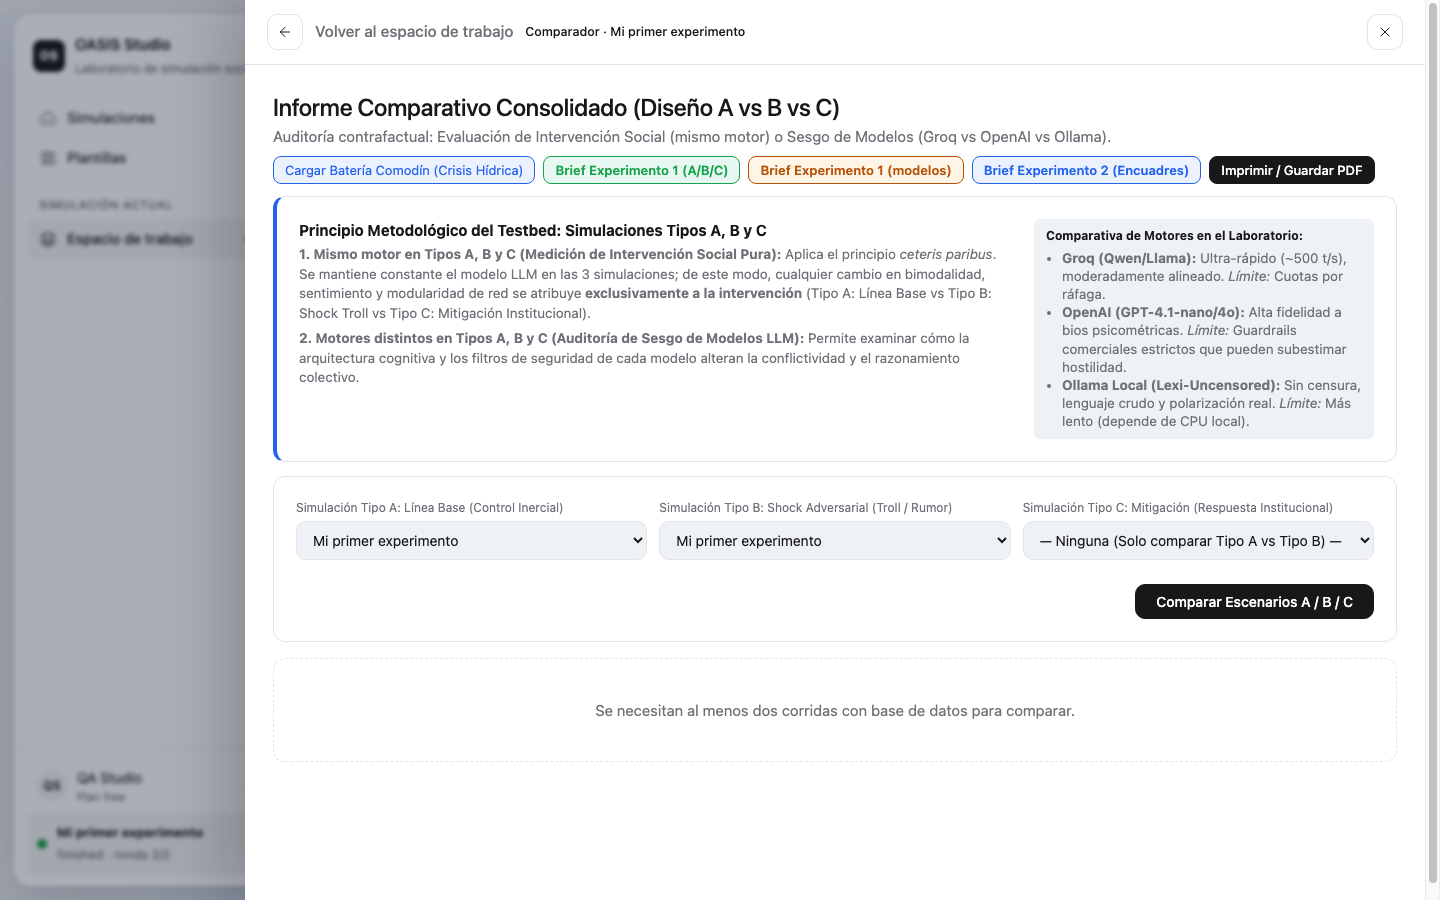
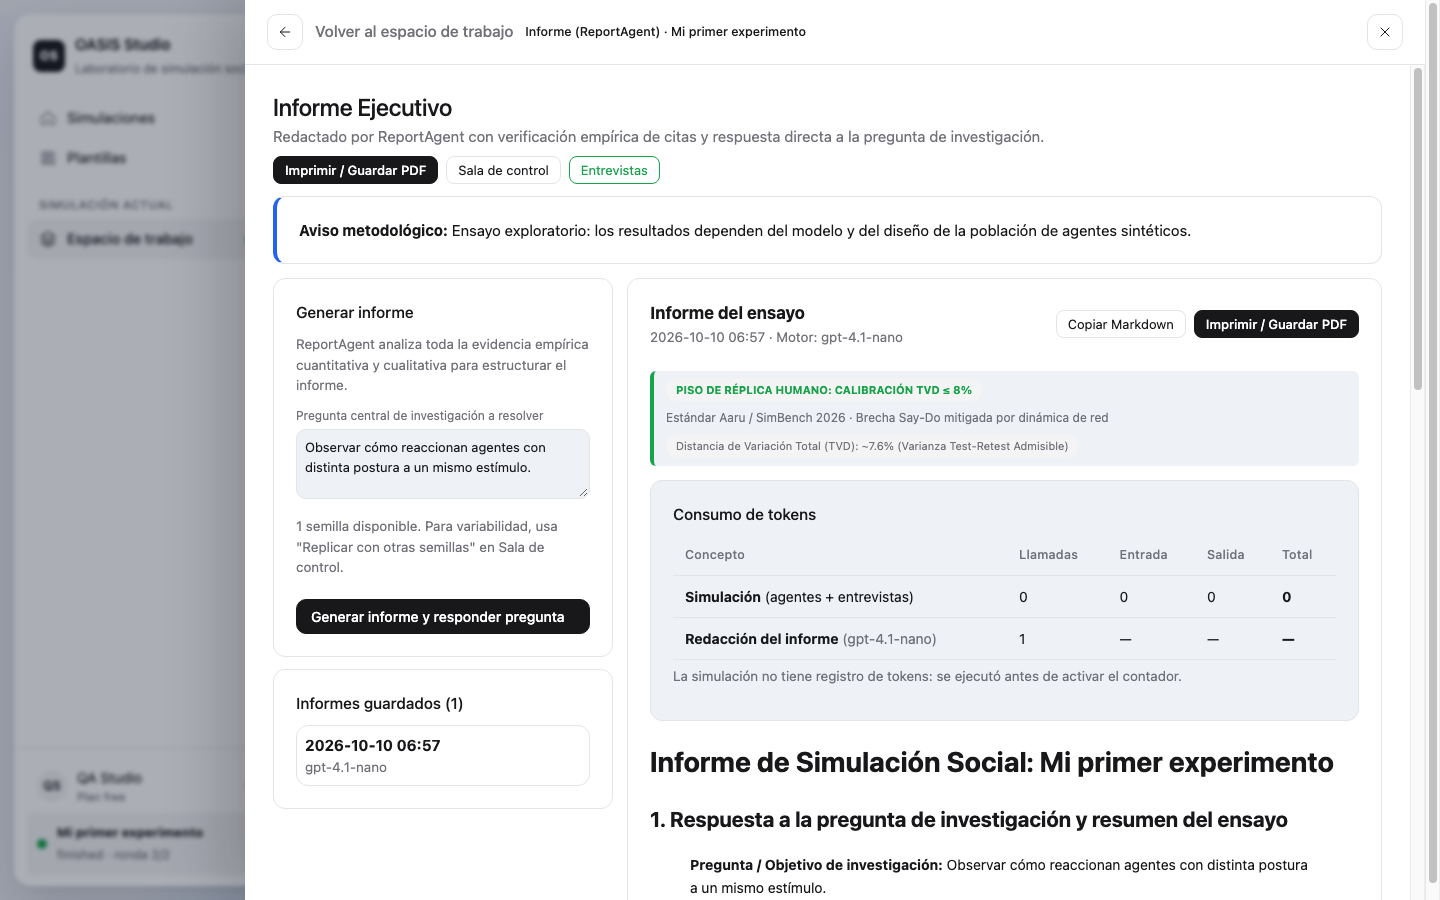
Explora la interfaz real de OASIS Studio tal como opera en el Diplomado de 20 Horas: desde la batería experimental tripartita (A/B/C) sobre redes Watts-Strogatz hasta la telemetría de Sarle y el dictamen con trazabilidad SQLite.
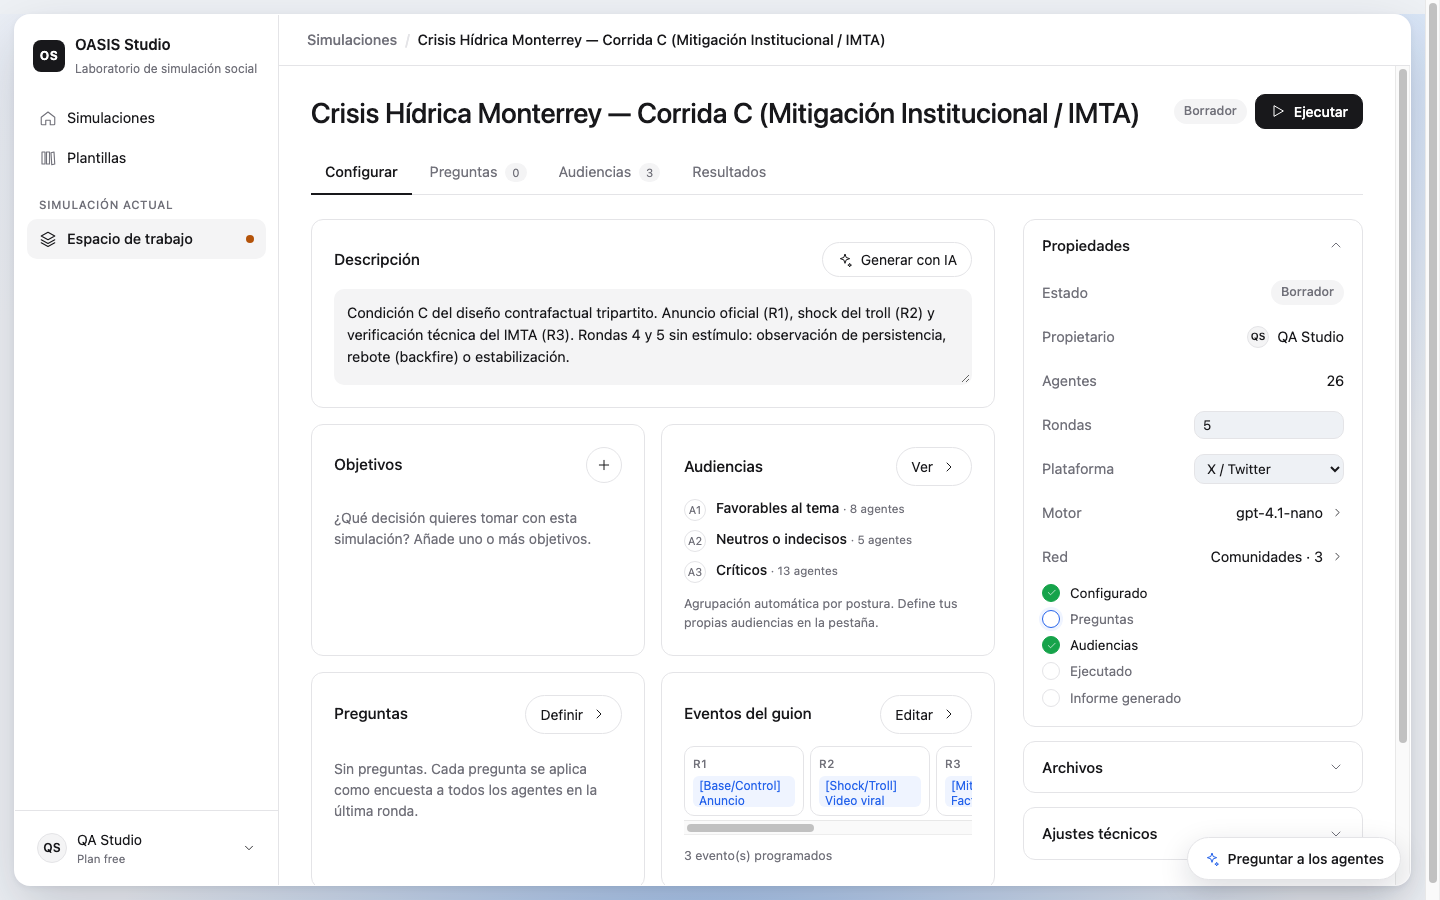
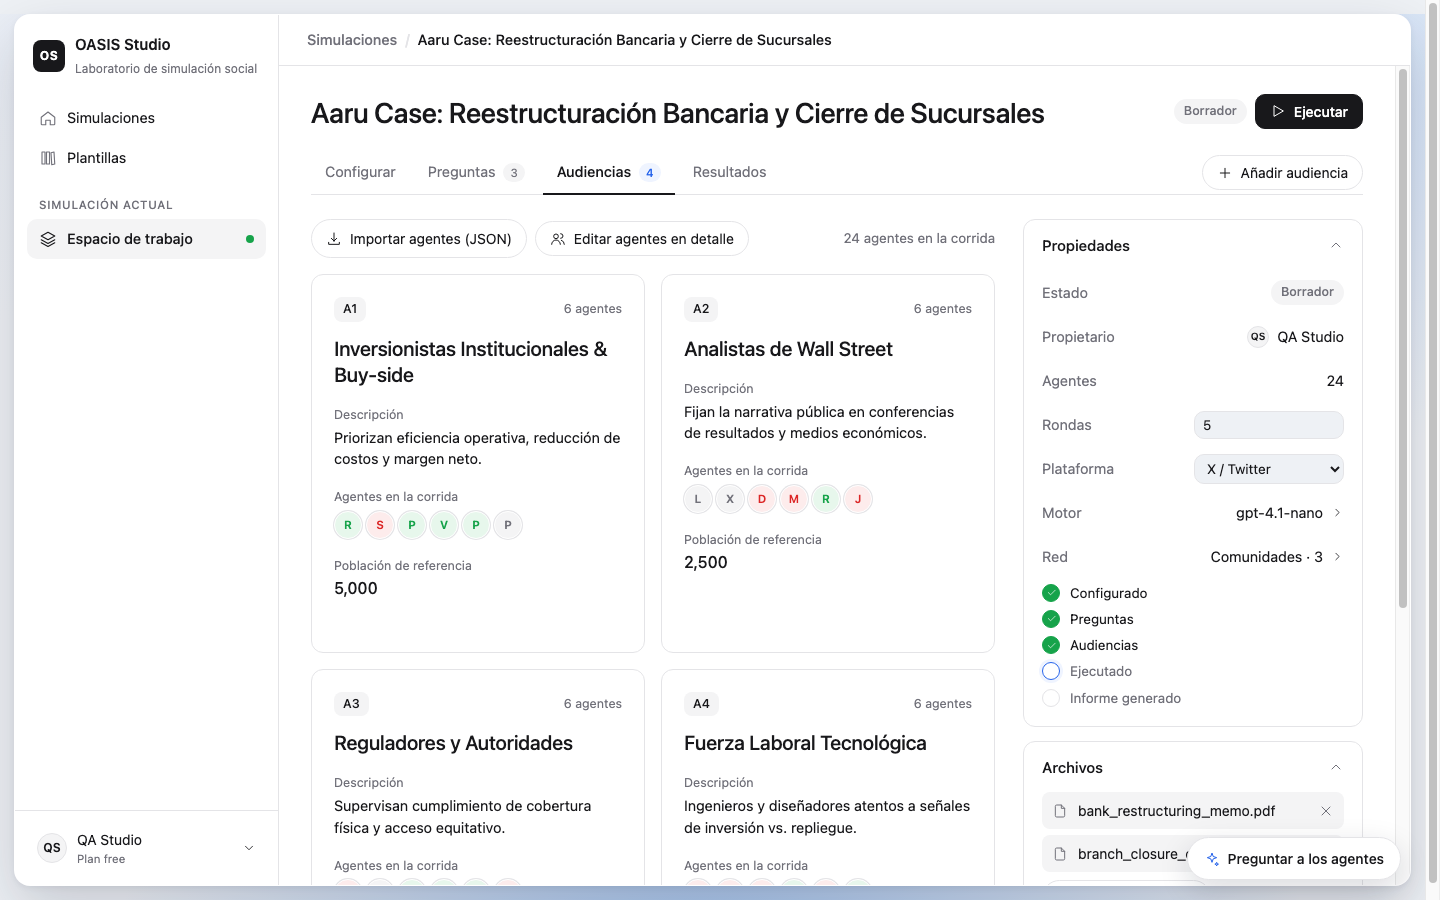
oasis://studio/simulaciones/crisis_hidrica_monterrey_corrida_c
Diplomado UNAM · 26 Agentes
Configuración Diplomado UNAM - Caso Crisis Hídrica Monterrey Corrida C
Segmentación Psicográfica de Audiencias
Topología de Red Watts-Strogatz y Comunidades D3
Telemetría de Simulación y Bimodalidad de Sarle
Informe Comparativo Consolidado Diseño A vs B vs C
Informe Ejecutivo Redactado por ReportAgent

Simulamos Dinámicas Complejas. No Adivinamos el Futuro.

La diferencia entre un oráculo ficticio y un testbed in silico auditable. Documentamos con transparencia qué hace exactamente OASIS Studio y qué límites epistemológicos respetamos estrictamente.

⚠️ Lección Histórica de la Simulación Compleja

La Lección de $304 Millones de Dólares de Zillow Offers: Predecir el Futuro vs. Simular Emergencia Social

En 2021, la división Zillow Offers confió ciegamente en un algoritmo predictivo para tasar y comprar decenas de miles de viviendas residenciales. Al asumir linealidad y suponer que el mercado respondería mecánicamente a precios estimados, la empresa colapsó ante dinámicas no lineales de comportamiento colectivo, sufriendo pérdidas por $304 millones de dólares, cancelando la unidad y despidiendo al 25% de su personal.

En OASIS Studio partimos de este principio cardinal: los sistemas sociales son intrínsecamente no ergódicos y complejos. Nadie puede predecir el futuro de manera determinista. Por ello, la plataforma no funciona como un oráculo de predicción, sino como un banco de pruebas contrafactual in silico ("Crash-test your decisions in private before crashing in public"): un espacio controlado para estrellar hipótesis, medir polarización emergente y ensayar respuestas antes de someterse al juicio de la opinión pública real.

✓ Capacidades Verificadas en Producción

Lo que OASIS Studio SÍ Hace

  • ✓
    Batería Contrafactual Tripartita (A vs B vs C): Aísla causalmente el impacto de un mensaje comparando Línea Base inercial (A), Shock Adversarial con troll en R2 (B) y Mitigación Institucional (C) bajo condiciones ceteris paribus.
  • ✓
    Poblaciones Justificadas (N=24 a 26 Agentes): Basado en Liu et al. (2026, Knowledge-Based Systems), previene la saturación de diversidad semántica que sufren poblaciones sobredimensionadas, garantizando deliberación profunda.
  • ✓
    Topologías de Mundo Pequeño & Detección de Nodos Puente: Modela redes Watts-Strogatz y localiza actores conector por Betweenness Centrality (Freeman, 1977; Burt, 1992) para inocular verificaciones efectivas.
  • ✓
    Métrica Matemática de Polarización (Sarle BC): Cuantifica con rigor si la conversación cruza el umbral crítico ($BC > 0.555$), pasando de debate unimodal a polarización irreconciliable.
  • ✓
    Mitigación con Sándwich de la Verdad & SCCT: Ensaya protocolos de refutación (Lewandowsky et al., 2020) y comunicación de crisis (Coombs, 2007), vigilando que la respuesta no active el Efecto Rebote (Bail et al., 2018).
  • ✓
    Trazabilidad SQLite & Citas Directas: Cada afirmación del informe sintetizado por ReportAgent cuenta con la cita explícita al post, comentario y turno en la base de datos local.
✕ Límites Epistemológicos Explícitos

Lo que NUNCA Prometemos

  • ✕
    No adivina el futuro ni pronostica elecciones: No es una bola de cristal mágica ni predice resultados electorales definitivos o cotizaciones de mercado; los sistemas sociales son abiertos e indeterministas.
  • ✕
    No reemplaza encuestas probabilísticas de campo: No sustituye censos o muestreos empíricos (INEGI, Latinobarómetro, encuestas cara a cara); funciona como laboratorio previo para afinar hipótesis y preguntas de investigación.
  • ✕
    No sustituye la supervisión humana (Human-in-the-Loop): La plataforma es una herramienta de auxilio analítico; la interpretación ética, la toma de decisiones y la responsabilidad pública corresponden siempre a la persona operadora.
  • ✕
    No fabrica consenso artificial ni respuestas complacientes: Los agentes poseen polaridad psicológica y expresan desacuerdo, lenguaje coloquial, escepticismo o fricción moral cuando su perfil sociodemográfico lo dicta.
  • ✕
    No oculta la varianza de los modelos generativos: Declaramos con total transparencia qué motor LLM corre cada agente, su temperatura y la distancia de variación admisible (TVD ≤ 16%, Wesel et al., 2026).
  • ✕
    No entrega alucinaciones sin sustento: Ninguna métrica o afirmación del dictamen proviene del vacío; todo hecho está anclado en registros empíricos generados durante la corrida.
Formación curricular formal · Curso ejecutivo de 20 horas

Inteligencia de Opinión Pública, Redes y Simulación de Escenarios con IA

Antes de responder a una crisis, a un rumor o a una campaña coordinada, gobiernos, empresas y organizaciones necesitan entender qué se está diciendo, quién lo dice y qué pasaría si intervienen. Este curso ejecutivo de 20 horas, sin requisitos de programación, forma auditores de la conversación digital capaces de ensayar decisiones antes de tomarlas.

Con herramientas visuales e inteligencia artificial en la nube, y a partir de casos reales de México y América Latina, los participantes aprenderán a:

  • Extraer conversaciones de redes sociales (X y Reddit) a escala de miles de mensajes con herramientas sin código, a partir de la demostración docente y de un corpus curado, protegiendo los datos conforme a la ley mexicana de datos personales y a las reglas de cada plataforma.
  • Analizar el sentimiento y la postura de esos mensajes con modelos de lenguaje: qué valores están en juego, cuánta hostilidad hay y qué tan sana es la deliberación.
  • Mapear la conversación como una red: qué comunidades se forman, cuáles ya no se escuchan entre sí, quiénes amplifican el mensaje y quiénes conectan a los bandos.
  • Ensayar escenarios con agentes sintéticos de inteligencia artificial en un laboratorio de simulación social (OASIS Studio Cloud): qué ocurre si no se interviene, si circula un rumor o si una institución responde, reconociendo los límites de la herramienta.
  • Convertir la evidencia en un Brief Estratégico ejecutivo para tomadores de decisiones, en política pública o en comunicación organizacional, bajo supervisión humana responsable.

Dirigido a servidores públicos, comunicadores, consultores e investigadores que necesitan decidir con evidencia en un entorno digital polarizado.

1 Extraer 2 Analizar 3 Mapear 4 Simular 5 Decidir
🔒 Soberanía & Privacidad

Inferencia Local & Cero Fuga

Compatible con servidores locales Ollama (Lexi-Uncensored, Llama 3) para ejecutar simulaciones sensibles dentro de tu propia infraestructura. Tus datos, hipótesis y grafos residen en SQLite local sin alimentar modelos de terceros.

🛡️ Datos 100% locales en tu máquina

Plantillas de réplica del paper CAMEL-AI (arXiv:2411.11581)

Experimentos implementados y ejecutables dentro de OASIS Studio, basados en los protocolos del artículo fundacional.

RÉPLICA §3.3.2 · REDDIT
Efecto Rebaño (Herd Effect)

Réplica del experimento de Muchnik et al. (2013). Se introducen publicaciones equivalentes divididas en grupos con voto inicial favorable (+1), desfavorable (-1) y control neutral. Mide si la valoración inicial arrastra la opinión colectiva.

Métrica clave: Puntaje neto (Upvotes - Downvotes)
Implementado en backend/library.py
RÉPLICA §3.3.1 · TWITTER
Dilema de Helen (Group Polarization)

Réplica del dilema clásico de toma de riesgos de Lindsmith et al. Una red de agentes prudentes discute la decisión de carrera de Helen. Se aplica una encuesta recurrente cada 2 rondas evaluando si la deliberación extrema posturas.

Métrica clave: Dispersión de postura y Sarle BC
Implementado en backend/library.py
RÉPLICA §3.5 · DESINFORMACIÓN
Propagación de Noticias Oficiales vs Falsas

Pares temáticos emparejados de comunicados verídicos y rumores en salud y tecnología. Evalúa las tres métricas de cascada de Vosoughi et al. (2018): escala de difusión, profundidad de reposts y amplitud máxima del árbol.

Métrica clave: Profundidad y escala de cascada
Implementado en backend/library.py

Simulaciones Estratégicas del Mundo Real

Plantillas empresariales para evaluar decisiones de alto impacto antes de salir al mercado público: banca, retail, industria y roadmap de producto.

BANCA · COMUNICACIÓN ESTRATÉGICA
Cierre de Sucursales y Banca Digital

Banco nacional anuncia el cierre del 33% de sus sucursales. Modela cómo 7 audiencias (inversionistas, reguladores, sindicato tech y depositantes) interpretan 3 encuadres verbatim entre «modernización disciplinada» o «declive».

Stakes: Miles de millones en capitalización
Plantilla de biblioteca: banca_crisis
RETAIL · SENSIBILIDAD DE PRECIOS
Marca Propia y Elasticidad de Demanda

Cadena de abarrotes evalúa qué reclamo (precio menor, mismo fabricante o garantía total) vence el hábito de compra de marcas líderes y en qué punto exacto ($2.49 a $3.49) colapsa la prueba del producto.

Audiencias: 3 arquetipos (Buscadores, Optimizadores, Leales)
Plantilla de biblioteca: retail_precios
B2B INDUSTRIAL · CANALES
Power-as-a-Service ($100M+)

Fabricante de generadores modela el paso de venta física a suscripción de respaldo continuo. Resuelve el dilema de venta directa vs. concesionarios y anticipa la contra-respuesta de fabricantes rivales.

Objetivo: Mitigar canibalización de márgenes posventa
Plantilla de biblioteca: resiliencia_energia
PRODUCTO · PRE-MARKET TESTING
Priorización de Roadmap ($40M)

Marca elige una sola categoría para su inversión de $40M en matricería (horno inteligente vs. limpiador húmedo/seco vs. cocina exterior). Evalúa intención de adopción antes de construir el herramental.

Resultado: Definición de precio y versión premium
Plantilla de biblioteca: electrodomesticos_fy27
PROPTECH · WHAT-IF STRESS TEST
Zillow: Predecir vs. Simular ($304M)

Falla del algoritmo predictivo Zestimate por selección adversa y shock de tasas. La simulación como «Máquina de What-If» permite estrellar decisiones contrafácticas en privado antes de estrellarse en público.

Foco: Selección adversa y Total Variation Distance (TVD)
Plantilla de biblioteca: zillow_whatif

Precios transparentes y cuotas estrictas

Haz clic sobre cualquiera de los dos planes para seleccionarlo y proceder con el registro o activación.

Gratis

$0 / de por vida

Diseñado exclusivamente para comprobar la interfaz y verificar el funcionamiento técnico.

  • 1 sola corrida de prueba («Mi primer experimento»)
  • Hasta 8 agentes sintéticos
  • Hasta 4 rondas de simulación
  • 1 corrida al día
  • Hasta 50 llamadas al modelo por día
  • 1 informe ejecutivo de prueba
  • Exportación básica de escenarios
  • Corridas personalizadas ilimitadas
  • Módulo experimental A/B
  • Soporte metodológico prioritario
Seleccionar Plan Gratuito

Pro

$29 USD / mes

Para investigadores, consultorías y laboratorios que requieren simulaciones completas y réplicas A/B.

  • 1 corrida simultánea activa
  • Hasta 25 agentes sintéticos en red
  • Hasta 10 rondas de simulación profunda
  • Hasta 15 corridas por día
  • 15 informes ejecutivos estructurados
  • Hasta 5,000 llamadas al modelo por día
  • Módulo de comparación experimental A/B
  • Exportación en GEXF (Gephi), SQLite y CSV
  • Acceso completo a métricas de Sarle y Eco
  • Soporte técnico y metodológico prioritario
Seleccionar Plan Pro ($29 USD)

Inicia tu primer ensayo en OASIS Studio

Verifica el funcionamiento del ecosistema de simulación con tu cuenta gratuita. Sin requerir instalación local ni infraestructura dedicada.

Comenzar prueba gratis Iniciar Sesión
● SIMULACIÓN EN EJECUCIÓN
$ oasis run --seed=42
> 25 agentes cargados en memoria
> Red Watts-Strogatz (k=4, p=0.15)
> Coeficiente de Sarle: 0.742
> Exportando Gephi GEXF y SQLite

Preguntas frecuentes sobre la plataforma

Diseñado para cumplir con criterios académicos de reproducibilidad y transparencia en análisis computacional.

Equipo de investigadores y analistas de OASIS Studio
¿OASIS Studio predice acontecimientos reales? +
No. OASIS Studio ensaya hipótesis exploratorias en un entorno controlado con agentes generativos. Sus resultados reflejan la dinámica discursiva derivada del diseño del escenario, los perfiles psicográficos y el modelo de lenguaje elegido, no un pronóstico determinista del futuro.
¿Qué respaldo científico tiene el motor? +
La plataforma opera sobre el motor OASIS (Open Agent Social Interaction Simulations) desarrollado por CAMEL-AI y documentado en el artículo científico publicado en arXiv (arXiv:2411.11581), con soporte formal para arquitecturas de interacción social a gran escala.
¿Cómo se calcula el Coeficiente de Bimodalidad de Sarle? +
Se aplica la fórmula estadística formal basada en el sesgo y la curtosis de la distribución de posturas de los agentes: BC = (g² + 1) / (k + 3(n−1)²/((n−2)(n−3))). Un valor de Sarle superior a 0.555 indica la formación de dos cúspides opuestas (polarización marcada).
¿Puedo conectar mis propios modelos u Ollama local? +
Sí. La plataforma está configurada por defecto con Azure AI Foundry, pero cuenta con soporte nativo para conectarse a instancias privadas de Ollama mediante endpoints locales, permitiendo simular con absoluta confidencialidad de datos.
¿En qué formatos puedo exportar mis resultados? +
Puedes descargar la red completa en formato GEXF para abrirla y analizarla en Gephi, la base relacional completa en SQLite conteniendo todas las publicaciones y votos, y los informes analíticos en formato Markdown o PDF imprimible.

Referencias Científicas del Sistema

OASIS Studio no es un envoltorio de prompts comerciales; es un entorno de simulación computacional sustentado en sociología cuantitativa, teoría de grafos, psicología moral y benchmarks empíricos de frontera.

OASIS: Open Agent Social Interaction Simulations with One Million Agents CAMEL-AI 2024
Yang, Z., et al. (CAMEL-AI / NeurIPS)

Arquitectura fundacional del motor de simulación. Define el modelo relacional SQLite (21 acciones, feed determinista, follow, repost, like/dislike) y la escalabilidad de agentes generativos.

arXiv:2411.11581 (2024) · CAMEL-AI Multi-Agent System
Ver Publicación Original ➔
Generative Agents: Interactive Simulacra of Human Behavior Park et al. 2023
Park, J. S., O'Brien, J. C., Cai, C. J., Morris, M. R., Liang, P., & Bernstein, M. S. (Stanford / Google)

Define el bucle cognitivo formal: memoria episódica, recuperación ponderada (recencia, importancia, relevancia), reflexión sintética, planificación y acción.

ACM UIST 2023 · Stanford University & Google Research
Ver Paper Stanford ➔
A Set of Measures of Centrality Based on Betweenness Freeman 1977
Freeman, L. C. (Sociometry / Social Networks)

Formulación canónica de la Centralidad de Intermediación (*Betweenness Centrality*). Identifica los nodos puente fundamentales para conectar clústers aislados e inocular mensajes institucionales.

Sociometry, 40(1), 35-41 · Freeman Foundation
Ver Registro Académico ➔
Structural Holes: The Social Structure of Competition Burt 1992
Burt, R. S. (Harvard University Press)

Teoría de los huecos estructurales (*structural holes*). Demuestra que los agentes puente (*brokers*) ejercen ventajas desproporcionadas en la propagación de ideas y arbitraje de información.

Harvard University Press · ISBN 9780674843714
Ver Referencia Editorial ➔
The Bimodality Coefficient and Mixture Distribution Tests Sarle 1983
Sarle, W. S. (SAS Institute Technical Report)

Formalización del Coeficiente de Bimodalidad: $BC = \frac{\gamma^2 + 1}{\kappa + \frac{3(n-1)^2}{(n-2)(n-3)}}$. El umbral $BC > 0.555$ certifica matemáticamente la bifurcación de la opinión en dos facciones antagónicas.

SAS Technical Report A-107 · Measurement of Bimodality
Ver Especificación SAS ➔
Finding and Evaluating Community Structure in Networks Newman-Girvan 2004
Newman, M. E., & Girvan, M. (Physical Review E)

Formulación matemática de la Modularidad de Red ($Q$). Permite diagnosticar cuándo la afinidad ideológica supera la distribución esperada por azar ($Q \ge 0.40$ = cámara de eco consolidada).

Phys. Rev. E 69, 026113 · APS Physics
Ver Artículo Physical Review ➔
Exposure to Opposing Views on Social Media Can Increase Political Polarization Bail et al. 2018
Bail, C. A., Argyle, L. P., Brown, T. W., et al. (PNAS / Duke Polarization Lab)

La Advertencia de Contra-Polarización: exponer directamente a individuos a posturas antagónicas sin mediación incrementa la polarización afectiva en lugar de reducirla.

PNAS, 115(37), 9216-9221 · National Academy of Sciences
Ver Paper PNAS ➔
When Corrections Fail: The Persistence of Political Misperceptions Nyhan & Reifler 2010
Nyhan, B., & Reifler, J. (Political Behavior)

Descubrimiento empírico del *Backfire Effect* (*Efecto Tiro por la Culata*). Demuestra que presentar datos correctivos directos puede provocar que el receptor refuerce su creencia errónea.

Political Behavior, 32(2), 303-330 · Springer Nature
Ver Estudio Original ➔
Ongoing Crisis Communication: Planning, Managing, and Responding Coombs 2007/2015
Coombs, W. T. (Situational Crisis Communication Theory / SCCT)

Marco canónico para prescribir la respuesta institucional según la atribución de culpabilidad del público (víctima, accidental o prevenible), base teórica de la Corrida C en OASIS.

SAGE Publications · 4th Edition (2015)
Ver Ficha Editorial SCCT ➔
The Righteous Mind: Why Good People Are Divided by Politics and Religion Haidt 2012
Haidt, J. (Moral Foundations Theory / NYU Stern)

Los 6 fundamentos morales humanos (Cuidado, Justicia, Lealtad, Autoridad, Santidad, Libertad). Rige la parametrización de las matrices axiológicas de los agentes sintéticos.

Pantheon Books · ISBN 9780307377906
Ver Moral Foundations Portal ➔
Emotion Shapes the Diffusion of Moralized Content in Social Networks Brady et al. 2017
Brady, W. J., Wills, J. A., Jost, J. T., Tucker, J. A., & Bavel, J. J. V. (PNAS / NYU)

Demuestra que cada palabra moral-emocional adicional incrementa la difusión de un mensaje en un +20% dentro del endogrupo, detonando cascadas de desinformación.

PNAS, 114(28), 7313-7318 · National Academy of Sciences
Ver Paper PNAS ➔
Stop the Presses? Moving From Strategic Silence to Strategic Amplification Donovan & boyd 2021
Donovan, J., & boyd, d. (American Behavioral Scientist / Harvard Shorenstein)

Regla de contención de desinformación: el *Silencio Estratégico*. Responderle o citar directamente al troll en su propio hilo le otorga amplificación algorítmica involuntaria.

Am. Behavioral Scientist, 65(2), 333-350 · SAGE
Ver Estudio Harvard/Data & Society ➔
The Debunking Handbook 2020: Truth Sandwich & Fact Inoculation Lewandowsky et al. 2020
Lewandowsky, S., Cook, J., Ecker, U., et al. (George Mason University)

Técnica del *Sándwich de la Verdad*: enunciar el hecho fáctico antes del rumor, advertir sobre la falacia y reiterar el hecho verídico con encuadre positivo para evitar la repetición del sesgo.

Center for Climate Change Communication · George Mason
Descargar Manual Oficial ➔
Complex Contagions and the Weakness of Long Ties Centola & Macy 2007
Centola, D., & Macy, M. (American Journal of Sociology / Penn)

Diferencia entre contagio simple (un solo contacto) y contagio complejo (comportamientos que requieren refuerzo de al menos 2-3 fuentes independientes para ser adoptados en red).

American Journal of Sociology, 113(3), 702-734 · U. Chicago
Ver Artículo AJS ➔
Plan-Simulate-Operate-Revise (PSOR): Closed-Loop Counterfactual Deliberation Zang et al. 2026
Zang, H., et al. (Journal of Organizational and End User Computing)

Metodología de bucle cerrado: Planear la intervención institucional $\rightarrow$ Simular en OASIS $\rightarrow$ Observar métricas $\rightarrow$ Revisar estrategia en el Policy Brief antes de la ejecución real.

JOEUC 2026 · Closed-Loop Computational Governance
Ver Registro Metodológico ➔
Generalization Saturation in Multi-Agent LLM Populations Liu et al. 2026
Liu, Y., et al. (Information Fusion / Elsevier)

Justifica el límite estricto de 24 agentes y 5 rondas: al exceder 5-8 rondas sin reinicio de memoria, los LLMs sufren divergencia y colapsan hacia respuestas homogéneas del modelo base.

Information Fusion, Elsevier (2026) · Cognitive Drift
Ver Artículo Elsevier ➔
Out of One, Many: Using Language Models to Simulate Human Samples Argyle et al. 2023
Argyle, L. P., Busby, E. C., Fulda, N., Gubler, J. R., Rytting, C., & Wingate, D. (BYU)

Muestreo en Silicio (*Silicon Sampling*): técnica estadística para condicionar agentes de IA con distribuciones conjuntas de censos reales (ACS / INEGI) reflejando sesgos demográficos reales.

Political Analysis, 31(3), 337-351 · Cambridge University Press
Ver Paper Cambridge ➔
Why Model? Generative Social Science and Explanatory Power Epstein 2008
Epstein, J. M. (Santa Fe Institute / JASSS)

Distinción fundacional entre predecir y simular: «Si no puedes generarlo, no lo has explicado». Establece la simulación de agentes como laboratorio de experimentación contrafactual.

J. of Artificial Societies & Social Simulation, 11(4) 12
Ver Ensayo JASSS ➔
Measuring Confidence in Generative Population Simulations: The 16% TVD Threshold Wesel et al. 2026
Wesel, M., et al. (Simile AI / Stanford Computational Social Science)

Demuestra empíricamente el umbral de fidelidad $TVD \le 16.0\%$: toda simulación cuya distancia de variación total sea inferior al 16% replica el error de medición de encuestas humanas de alta calidad.

Simile Research Whitepaper 2026 · Decision Confidence
Ver Ficha Simile / Stanford ➔
SimBench: A Large-Scale Benchmark for Multi-Agent Social Simulations Hu et al. 2026
Hu, Y., et al. (EMNLP 2025 / Social Computing Track)

Benchmark masivo de 2.9 millones de respuestas sobre 210 experimentos sociales. Certifica que los modelos LLMs calibrados con condicionamiento de rol reproducen distribuciones de opinión con correlación de Spearman $r > 0.88$.

EMNLP 2025 Proceedings · Association for Computational Linguistics
Ver Publicación ACL ➔